Intern is AI een hulpmiddel. In je primaire proces is het je dienst.
Wij zijn sinds kort partner van orq.ai. Niet omdat we iets nieuws zochten, maar omdat we bij klanten een vraag tegenkomen waar ander gereedschap bij hoort. Waar die grens ligt, en waarom hij niet gaat over hoe ver je bent.
De vraag die we steeds vaker horen
Kort geleden zaten we bij een klant die AI al een tijd in het dagelijks werk heeft. Geen pilot, geen proef, gewoon productie. Er draaien tientallen agents, gebouwd door de mensen die het werk zelf doen, en ze worden elke dag gebruikt.
De vraag op tafel ging niet over hoe ze meer uit die werkplek konden halen. De vraag was of ze er producten en diensten van konden maken die ze aan hun eigen klanten leveren en exploiteren. Niet AI gebruiken om beter te werken, maar AI gebruiken om iets te verkopen.
Zodra je dat wilt, lopen er twee dingen vast. Het eerste is multi-tenancy: je kunt medewerkers van je klant niet in dezelfde werkomgeving zetten als waar jouw eigen kennis en data staan. Het tweede is dat er geen scheiding is tussen ontwikkeling en productie. Iemand past iets aan, en de agent die gisteren goed werkte doet het vandaag niet meer. Intern is dat vervelend. Bij een klant is het een incident met een naam eronder.
Dit is het punt waarop wij al een tijdje merkten dat we iets misten. Niet een beter platform om op te werken, maar een controlelaag eronder.
Waar de grens ligt
De verleiding is om dit als een trap te zien. Eerst een AI-werkplek, dan iets zwaarders. Dat klopt niet, en het is een slecht kompas, want dan koop je iets omdat je vindt dat je er inmiddels aan toe bent.
Het is ook niet de vraag of de uitkomst je organisatie verlaat. Dat gebeurt allang. Je ontsluit een agent via de API, een systeem roept hem aan, en het antwoord gaat naar buiten. Dat kan prima in een AI-werkplek, en dat is precies wat het is: je eigen werk, geautomatiseerd.
De grens loopt bij de vraag of je AI inzet voor je eigen werk, of dat het onderdeel wordt van je primaire proces, van wat je aan je klanten levert en waar je op verdient.
Een agent via de API ontsluiten is nog geen platform. Het wordt een platform zodra er meerdere afnemers op draaien die niets van elkaar mogen zien.
Op dat moment veranderen er drie dingen tegelijk. Je krijgt meerdere afnemers op dezelfde technische basis, met harde scheiding tussen hun data en hun configuratie. Er komt een verdienmodel onder te liggen, dus je moet per afnemer weten wat het kost en wat het opbrengt. En je bent geen gebruiker meer maar leverancier, met alles wat daarbij hoort: releases, terugdraaien, en kunnen uitleggen wat er gebeurd is.
Dat is geen volgende trede, het is een andere vraag. De meeste organisaties komen die grens nooit tegen, en dat is geen achterstand. Je kunt jarenlang uitstekend werk leveren met AI in het dagelijkse werk en nooit één regel hoeven vastleggen over versiebeheer van een agent. Andersom geldt het ook: wie pas net begint kan er meteen aan de andere kant van staan, simpelweg omdat er een betalende afnemer aan hangt.
Hoe dat er concreet uitziet
Drie vormen die we in de praktijk tegenkomen, en ze beginnen alle drie klein.
Een toets die je nu met de hand doet. De klant levert een document aan, jouw agent legt het langs jouw eigen normenkader en geeft de bevindingen terug met een verwijzing naar de bron. Je verkoopt de toets in plaats van de uren.
Advies dat nu per uur gaat. Je maakt het online beschikbaar, zodat je ook de kleinere klanten kunt bedienen voor wie een adviestraject nooit uit kon. Hetzelfde vak, een ander leveringsmodel.
Dezelfde dienst onder de naam van een ander. Jij bent de motor, een partner zet er zijn naam op, en de eindklant ziet jou nooit. White label, en voor veel bureaus de snelste route naar volume.
Vier signalen dat je aan die kant van de grens staat:
- Meerdere afnemers draaien op dezelfde basis en mogen elkaars data en configuratie niet zien.
- Er zit een verdienmodel onder, dus verbruik en kosten moeten toerekenbaar zijn per afnemer en per dienst.
- Ontwikkeling en productie lopen door elkaar, dus elke wijziging staat meteen live bij iemand die ervoor betaalt.
- Je hebt geen registry: niemand kan opsommen wat er draait, wie eigenaar is en welke bronnen en tools eraan hangen.
Wat zo’n laag eigenlijk is
In de kern zijn het drie dingen die je één keer inricht en daarna overal geldt.
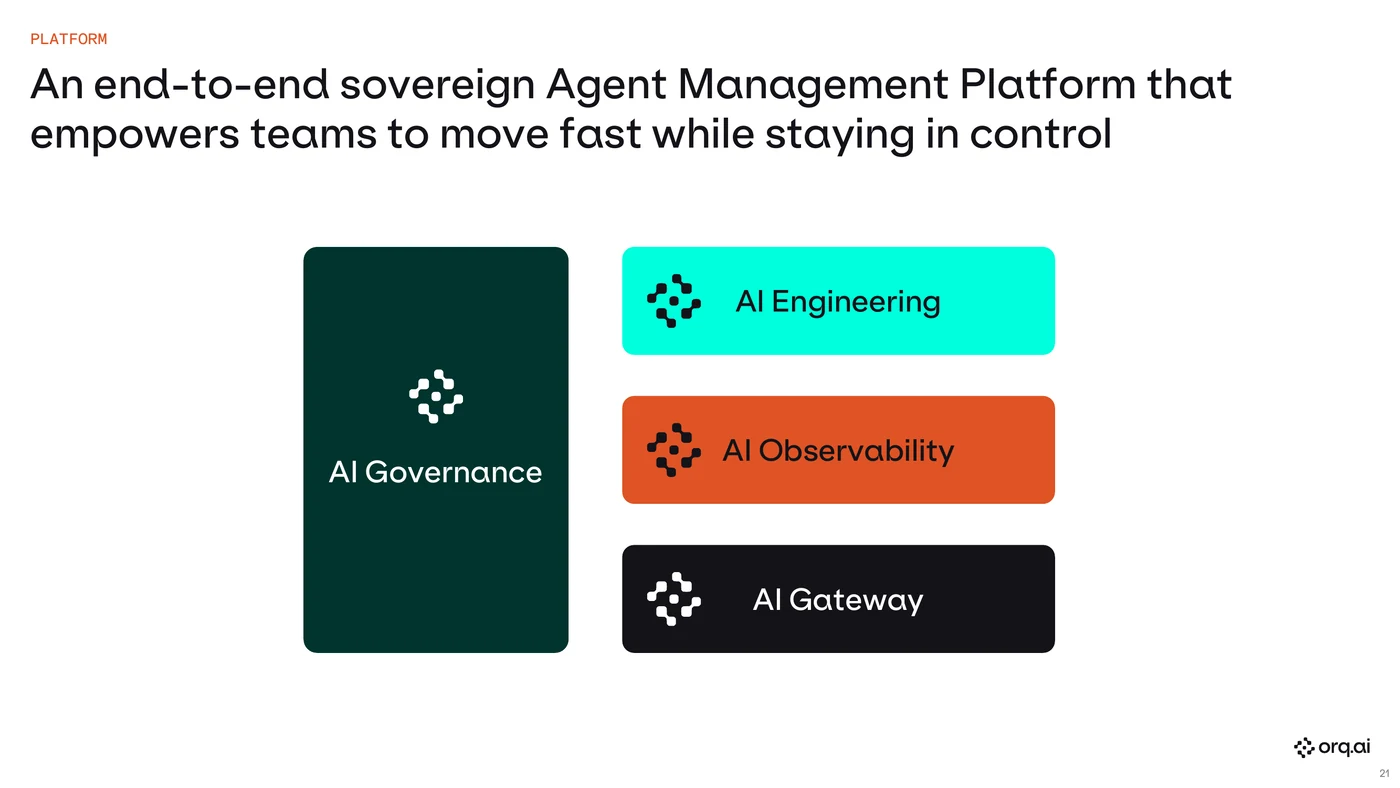
De gateway is waar het verkeer langsgaat. Daar bepaal je welke modellen zijn toegestaan, wat er gebeurt als een aanbieder eruit ligt, en welke tools een agent überhaupt mag aanroepen. Observability is wat je terugkijkt: traces per stap, met tijd, tokens en kosten, en analyses die op schaal samenvatten waar het misgaat. Governance is wie wat mag, welke agents bestaan, wie eigenaar is, en wat er nooit naar buiten mag.
Daarbovenop zit de bouwkant: agent builder, kennis en RAG, datasets, experimenten, versiebeheer. Dat is het deel dat lijkt op wat je in een AI-werkplek ook doet. Het verschil zit niet in het bouwen, het zit in de drie lagen eronder.
Wat er verandert zodra je exploiteert
Dit is grotendeels wat software-engineering al dertig jaar doet, toegepast op iets dat niet elke keer hetzelfde antwoord geeft. Het verschil met eigen gebruik is dat je daar eigenlijk maar op één ding let, namelijk of het antwoord klopt. Zodra er iemand voor betaalt, moeten er een stuk of vijf dingen tegelijk onder controle blijven.
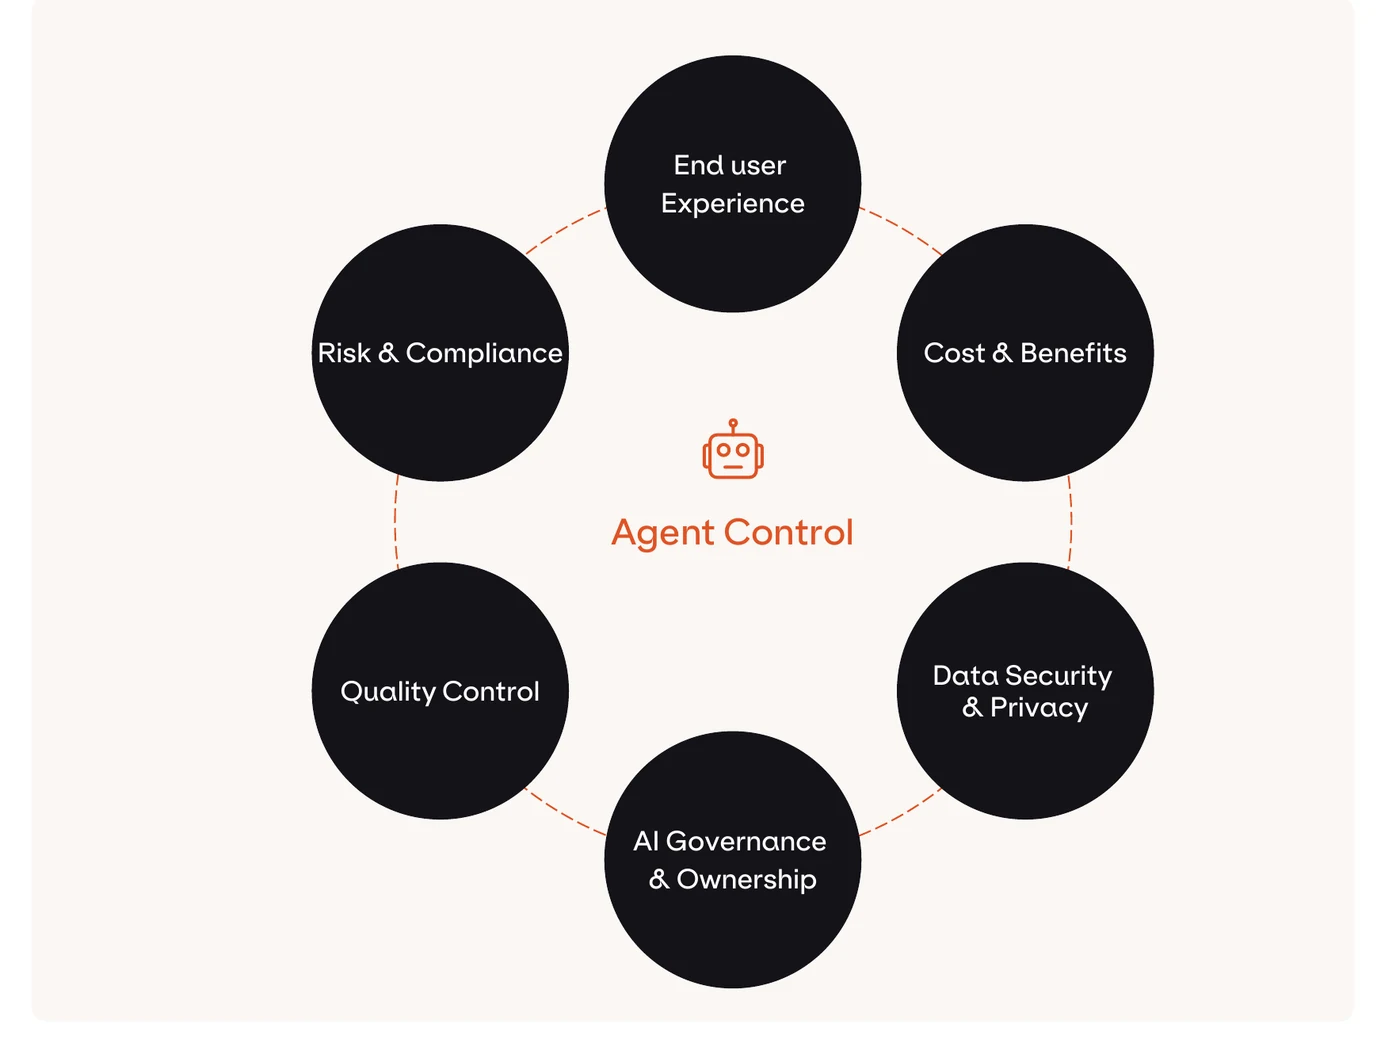
Elke agent krijgt een eigen OTAP. Je tagt een versie als acceptatie of als productie, de omgeving gaat mee in de aanroep, en het platform serveert de bijbehorende versie. Wat je ’s ochtends staat te verbouwen raakt de klant dus niet, en een tegenvallende release draai je terug. In vrijwel geen enkele AI-werkplek bestaat dat onderscheid, omdat het daar ook niet hoeft.
Kwaliteitsverlies wordt gesignaleerd in plaats van gemeld. Een agent die vandaag goed werkt kan over een kwartaal slechter zijn zonder dat iemand iets heeft aangepast. De bron is veranderd, of het model, of het type vragen. Daar zet je evaluators op. Offline over een testset tijdens het bouwen, online over een steekproef in productie om drift te zien. Wat echt kritisch is zet je als guardrail, dan wordt er geblokkeerd in plaats van achteraf teruggelezen.
Je kunt reconstrueren wat er gebeurd is. Per run elke stap, inclusief de aanroepen naar sub-agents en tools. Niet omdat je dat dagelijks nodig hebt, maar omdat de dag dat een klant belt met “dit antwoord klopt niet” anders een gissessie wordt.
Multi-tenancy: twee manieren om een klant te bedienen
Er zijn grofweg twee vormen, en het verschil zit in hoe zichtbaar het platform is.
De eenvoudigste is een eigen project of workspace per klant. Alles is fysiek gescheiden, jij schakelt ertussen, en je kunt desgewenst een of twee mensen van de klant uitnodigen om mee te kijken. Dat past goed bij samen ontwikkelen.
De tweede is white label. De eindklant logt in bij jou, ziet jouw naam, en komt nooit in het platform. Bij elke transactie stuur je identiteit en metadata mee, bijvoorbeeld organisatie-id en gebruikers-id als vrije sleutelwaarden, en daarmee bouw je per klant profielen en analytics op die je via de reporting-API terugleest. De authenticatie blijft bij jou, want het is jouw dienst.
Het platform is dan de backend van jouw backend. Je eindklant merkt er niets van, en dat is precies de bedoeling.
Die tweede vorm is voor meer organisaties interessant dan ze denken. Je hoeft geen softwarebedrijf te worden om iets te kunnen leveren. Je hoeft alleen het stuk vakkennis dat je al hebt aan te bieden op een manier waar je niet zelf elke keer bij hoeft te zitten.
Centraal governen, decentraal bouwen
De klassieke fout is om hier een centraal team omheen te zetten waar iedereen toestemming moet vragen. Dan wordt het een wachtrij en gaan de domeinteams eromheen werken, met shadow AI als resultaat. Het omgekeerde, waarbij elk team alles zelf regelt, levert vijf manieren van werken op en niemand met overzicht.
Wat wel werkt is een smalle centrale laag en verder niets: gateway, observability, governance. De domeinteams bouwen, rollen uit en verbeteren zelf, binnen die kaders, zonder iets te hoeven vragen. Wie uit de datawereld komt herkent het patroon van hub en mesh.
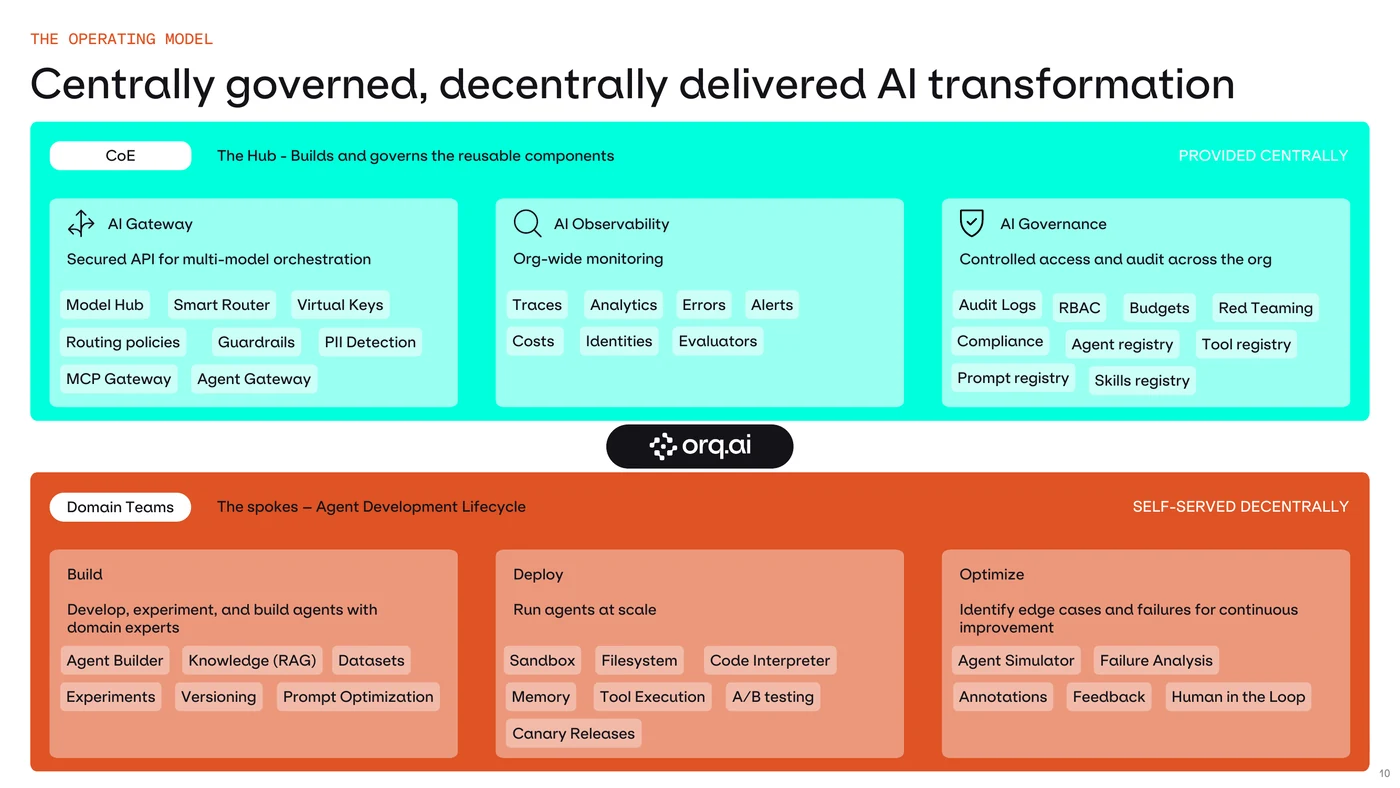
De technische inrichting van die bovenste band gaat snel, en dat is ook precies waar de verwachtingen scheeflopen. Het echte werk zit in het vertalen van je eigen vakkennis naar policies, skills en evaluators. Dat is maandenwerk en het is het enige deel dat niemand voor je kan doen. Wij zien het structureel onderschat worden, en het is meestal de reden dat zo’n traject uitloopt.
Soevereiniteit is een keten, geen vlaggetje
Voor wie in een gereguleerde sector zit is dit de eerste vraag, en het antwoord verdient meer precisie dan het meestal krijgt. Een server in Frankfurt is niet hetzelfde als een soevereine stack. Bij de laag zelf kun je kijken naar entiteit, aandeelhouders en bestuur, en orq.ai is op alle drie Europees.
Daarboven kies je modellen en daaronder draait infrastructuur, en dat blijven je eigen afwegingen. Je kunt filteren op Europese endpoints en op zero data retention, en er is keuze genoeg om die keuze serieus te maken. Het punt is vooral dat het onderhoud is en geen vinkje: wat vandaag klopt, controleer je volgend jaar opnieuw.
Waarom wij deze stap zetten
Een goed bewaard geheim bij ons: wij zijn Microsoft-partner. In theorie kunnen we heel veel met dat platform, en voor organisaties die daar al volledig in zitten is dat vaak de kortste route.
Daarnaast zijn we Langdock-partner van het eerste uur en inmiddels een van de go-to partners voor de Benelux. Dat blijven we, en dat is geen beleefdheidszin. Voor verreweg de meeste organisaties is een goede AI-werkplek precies wat er nodig is. Het is waar mensen hun werk doen, en dat is de plek waar de meeste waarde zit.
En sinds kort bouwen we onze samenwerking met orq.ai op. Niet als vervanging van iets, maar voor de klanten die die grens overgaan en van AI een eigen product of dienst maken.
Wij kiezen niet in jouw plaats. We zorgen dat je scherp hebt welke vraag je stelt, zodat je zelf kunt kiezen wat erbij hoort.
Dat is ook waarom we deze drie naast elkaar hebben en niet één favoriet. Wie maar één ding verkoopt, ziet overal dezelfde vraag.
Wij zijn Augmentic. Wij beginnen bij het werk, niet bij de tool. Zo halen organisaties echt het maximale uit AI, met grip op kwaliteit, kosten en rendement.
Denk je erover om van AI een eigen product of dienst te maken, en wil je weten wat daar dan bij hoort? Laten we praten.
Building better workdays.
In gewone taal
De vaktermen uit dit stuk op een rij, voor wie ze wil nakijken.
| Term | Wat het is |
|---|---|
| AI gateway | Eén punt waar al het modelverkeer langsgaat. Daar staan de sleutels, de routing, de fallbacks en de limieten, zodat je niet per applicatie hoeft te regelen welk model mag. |
| Observability | Elke stap van elke run terug kunnen lezen: welke tool werd aangeroepen, hoe lang het duurde, wat het kostte en waar het strandde. Die registratie heet een trace. |
| Evaluator | Een geautomatiseerde beoordeling van een antwoord, bijvoorbeeld op groundedness: blijft het bij de aangeleverde bron of begint het te zweven. |
| Guardrail | Dezelfde beoordeling, maar blokkerend. Slaat hij aan, dan gaat het antwoord niet de deur uit. |
| Registry | De centrale lijst van wat er bestaat en wie eigenaar is: agents, tools, prompts, skills. |
| ADLC | Agent development lifecycle. De tegenhanger van de SDLC: bouwen, testen, hardenen, red teamen, uitrollen en in productie blijven monitoren. |
| Multi-tenancy | Meerdere klanten op dezelfde technische basis, met harde scheiding tussen hun data en hun configuratie. |
| Soevereiniteit | Niet alleen waar de data staat, maar onder welke jurisdictie de entiteit, de eigendom en de zeggenschap vallen. |
Bronnen
- orq.ai, platform en documentatie
- Beeldmateriaal: orq.ai, AI Center of Excellence Enablement, 2026
- Langdock, Security & Compliance
- Europese Commissie, EU Cloud Sovereignty Framework
- Eigen sessie met orq.ai bij een klant, september 2026
Gerelateerde inzichten
-
 Soevereiniteit is geen bestemming, maar optionaliteit Digitale soevereiniteit wordt behandeld als een eindstaat die je bereikt met een groot migratieproject. Wij zien het als ontwerpprincipe. Wat het oplevert is optionaliteit: de vrijheid om te wisselen, ook als je dat nooit doet.
-
 Services-as-Software: A New AI-Driven Paradigm for Professional Services Services-as-Software (SaS), a term coined by Phil Fersht of HFS Research, is the shift from people-heavy projects and static software to AI-driven, outcome-focused services delivered like software. SaS is projected to become a $1.5T market by 2035 as software and services converge, reshaping how IT/BPO providers and advisory firms deliver value. It creates existential risk for “hours factories,” but also the biggest growth opportunity in a generation for firms that productize their expertise, embrace agentic AI, and move to scalable, subscription and outcome-based models.
-
 AI Agent Governance: Het beheersen van de aanstaande agent-explosie AI agents nemen razendsnel toe in aantal en complexiteit. Zonder duidelijke governance dreigt chaos en risico. Het IAPS-rapport benadrukt vijf cruciale principes voor verantwoord gebruik. Augmentic integreert deze via Palqee Prisma in BetterWorkdays.ai, waarmee organisaties agents transparant, veilig en mensgericht kunnen inzetten. De tijd om te handelen is nu.